 CHENGWAY.WANG
项目介绍
selfdistill 解决的是「每换一个 Agent,就要重新介绍自己一遍」这件事:我是谁、我怎么做事、哪些事我明确不接受。它把历史对话里这些内容蒸馏成一份可检查、可迁移、按需加载的个人档案,再喂给不同的 AI 工具。
它比「让模型总结聊天」多解决三个问题:来源可查(每条结论能回到原始对话)、人可确认(AI 只提候选、不改写自我定义)、范围可控(该加载什么加载什么)。
我的判断是:个人上下文不该是一段越写越长的 prompt,而应该是一组可检查、可迁移、可撤回的文件。
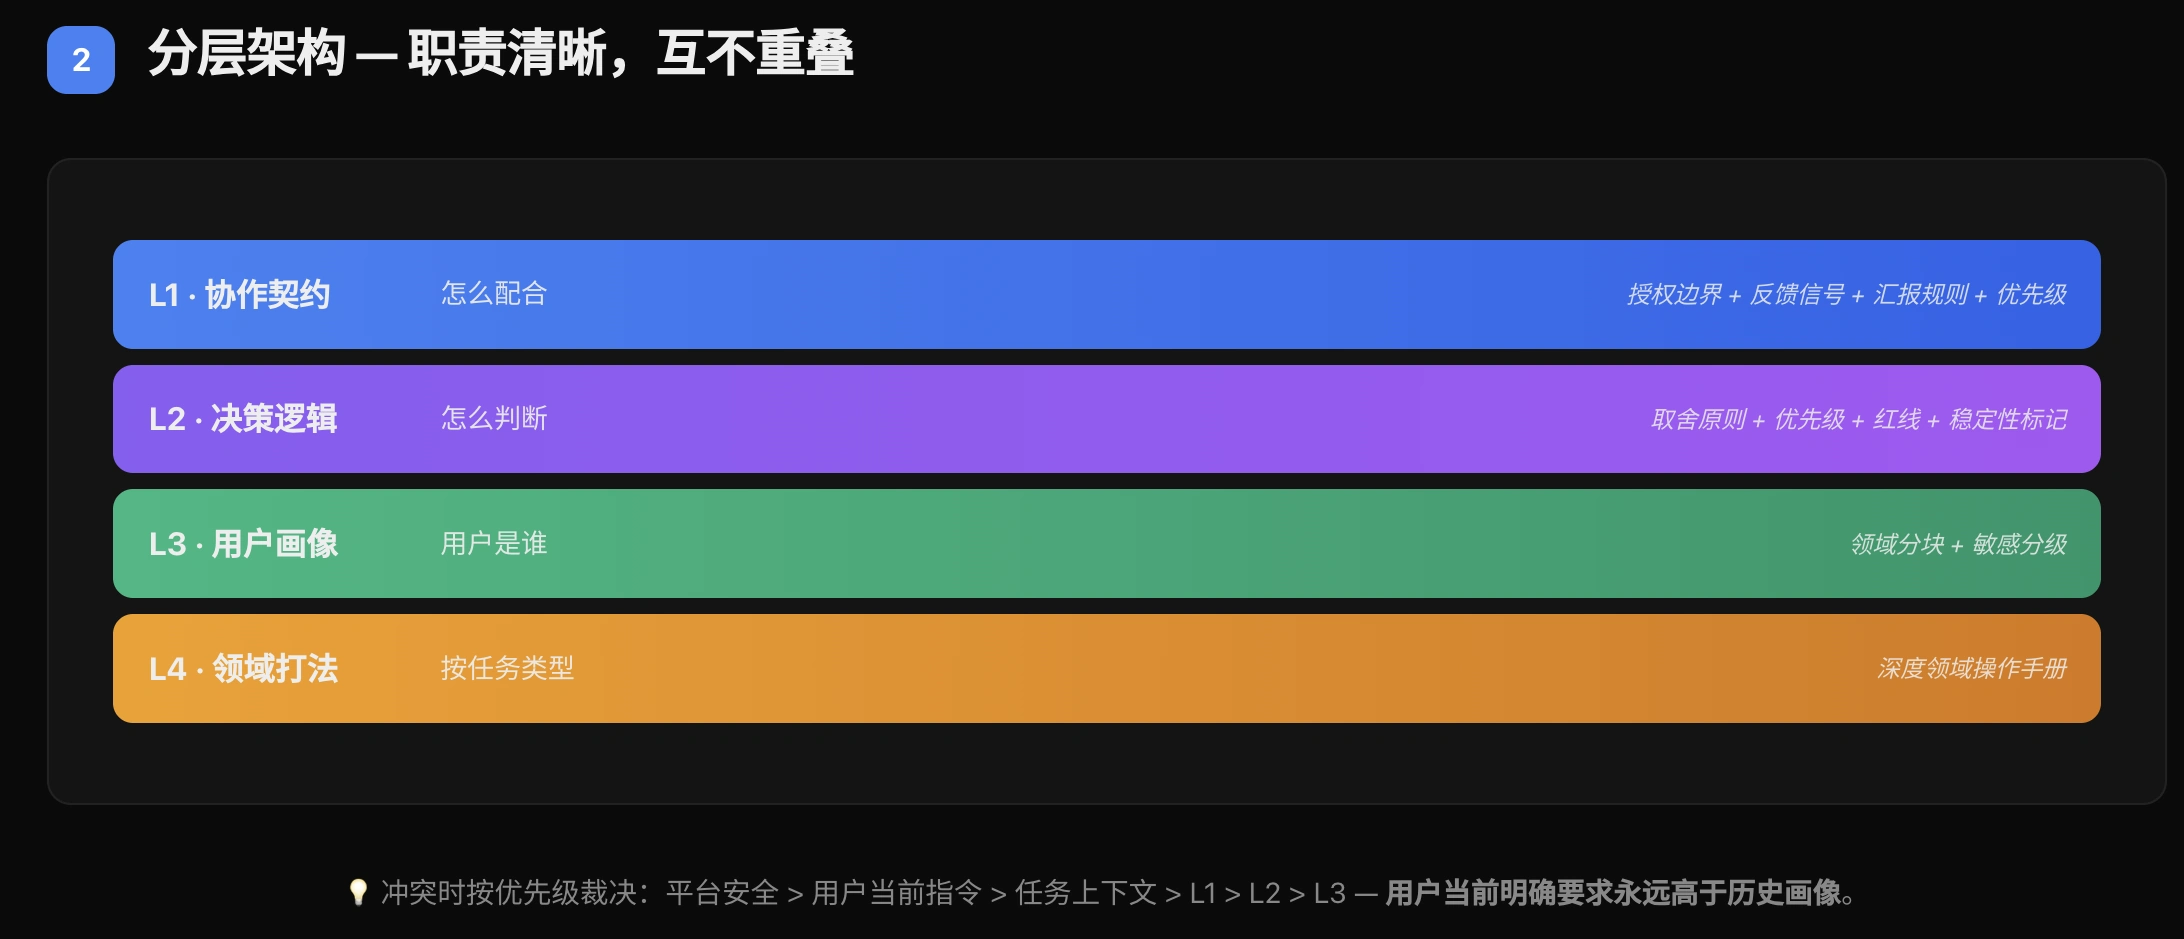
四个设计决定
- 分层存储、按需加载:契约、事实、偏好、简历分开存,加载策略不同——契约每次都要,偏好在相关任务里才加载,减少无关内容占用
- 只提候选,人工确认后才落盘:AI 可以提议「你似乎偏好 X」,但不能自己改写你对自我的定义
- 多端写回:Codex、Claude、DSH 等工具读同一份事实,避免每个工具里都有一个不一致的你
- 数据留在本机:日常沉淀不自动上云,只有蒸馏环节才调用模型
现在能做什么
- 本地 HTML 查看档案,随时读、改、删
- 多模型自由圆桌:同一份事实喂给不同模型,看它们怎么理解你
- 工作证据包可用于简历优化这类需要「事实为准」的场景
边界
它不是记忆插件,不自动抓取对话;产物是文档与技能文件,可读、可改、可删。数据留在本机,蒸馏环节才调用模型。
可迁移的判断
- 个人上下文的价值在「可撤回」:不能被检查和删除的记忆,没人敢用
- 让 AI 提候选、人做决定,是这类基础设施唯一能长期立住的边界
- 多工具并存是现实,一致的事实比聪明的推理更稀缺
- 分层加载的意义在「按需」:不是所有关于你的信息都该每次都进上下文