 CHENGWAY.WANG
一个人入职要交十类材料:身份证、银行卡、社保卡、毕业证、学位证、职业资格证、简历、离职证明、体检单、健康证。员工「录」和 HR「核」任一环节出错,都会拉低入职办理的效率。
这在劳动密集型行业尤其要命:赶上双 11 这类节点,企业要临时批量入职一批快递小哥或分拣员,录得慢、核得慢,错一处就要返工。
| 角色 | 产品负责人 + 项目管理 |
|---|---|
| 周期 | 2025.09 – 2025.12 |
| 覆盖 | 2,000+ 家客户企业,16 万+ 人次入职场景 |
| 范围 | 识别与填充、HR 智能预审、错误归因与追踪 |
1. 问题在哪
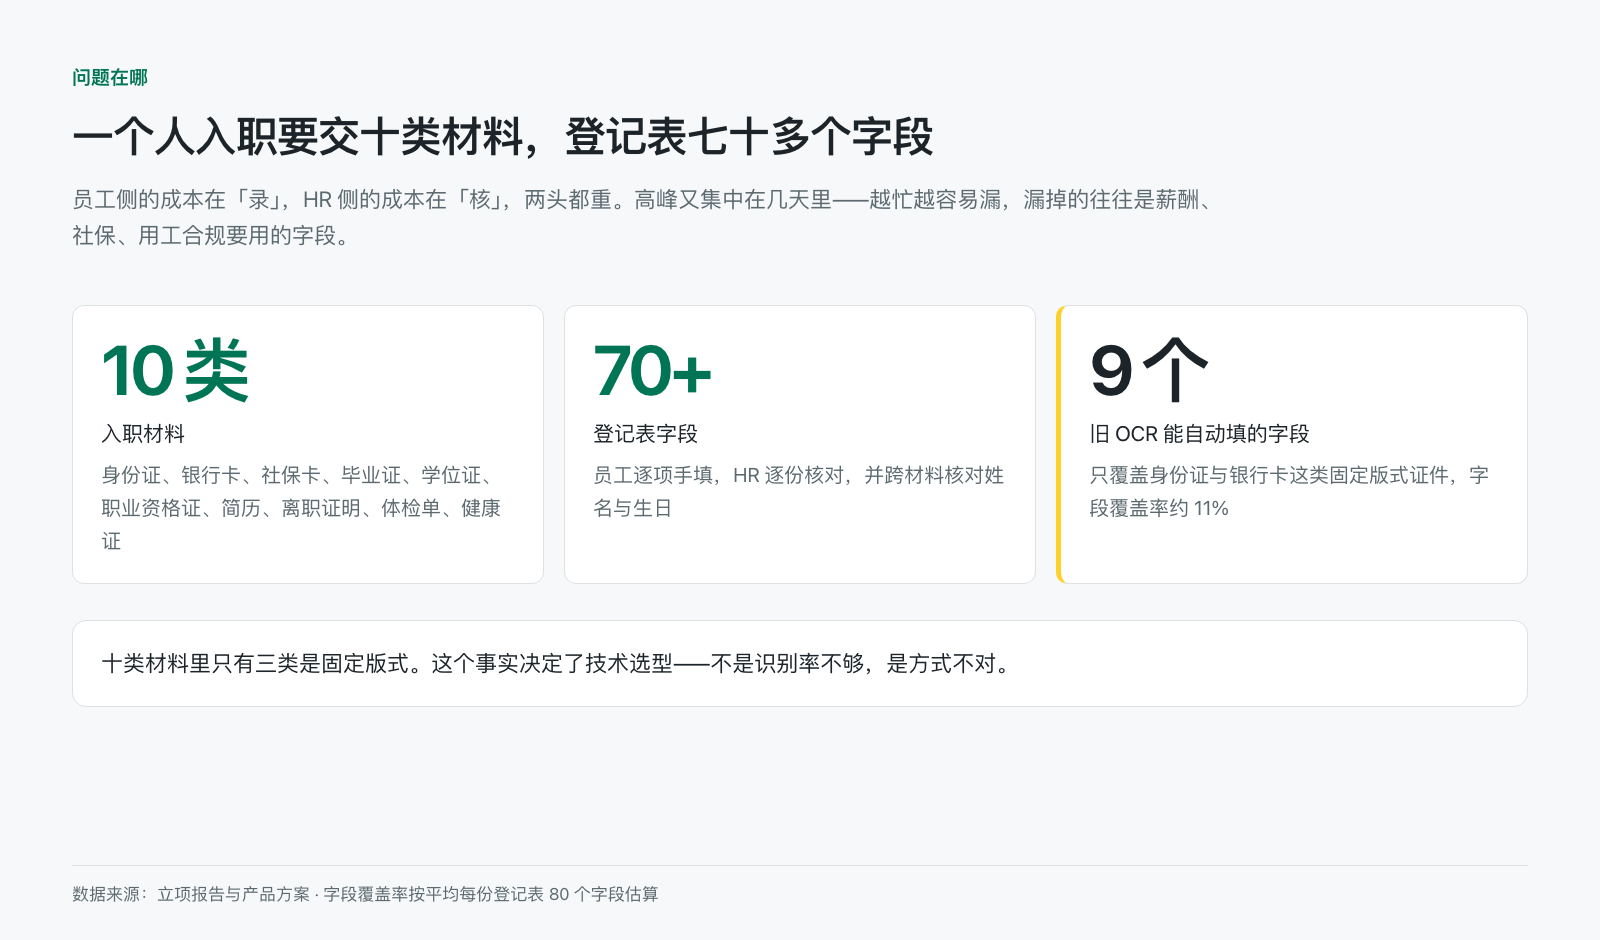
入职登记表七十多个字段,全靠员工手填、HR 逐份核对,并跨材料核对姓名和生日是否一致,错一处就返工。而扫码入职占总入职人数的 55% 以上,是新员工的核心路径。
旧方案只支持身份证和银行卡,能自动填的字段只有 9 个,字段覆盖率约 11%。学历证、体检单、离职证明一律失效。
入职高峰集中在几天内,越忙越容易漏,漏掉的往往是薪酬、社保、用工合规要用的字段。
2. 为什么不用传统 OCR
把十类材料按版式拆开,问题立刻显形:
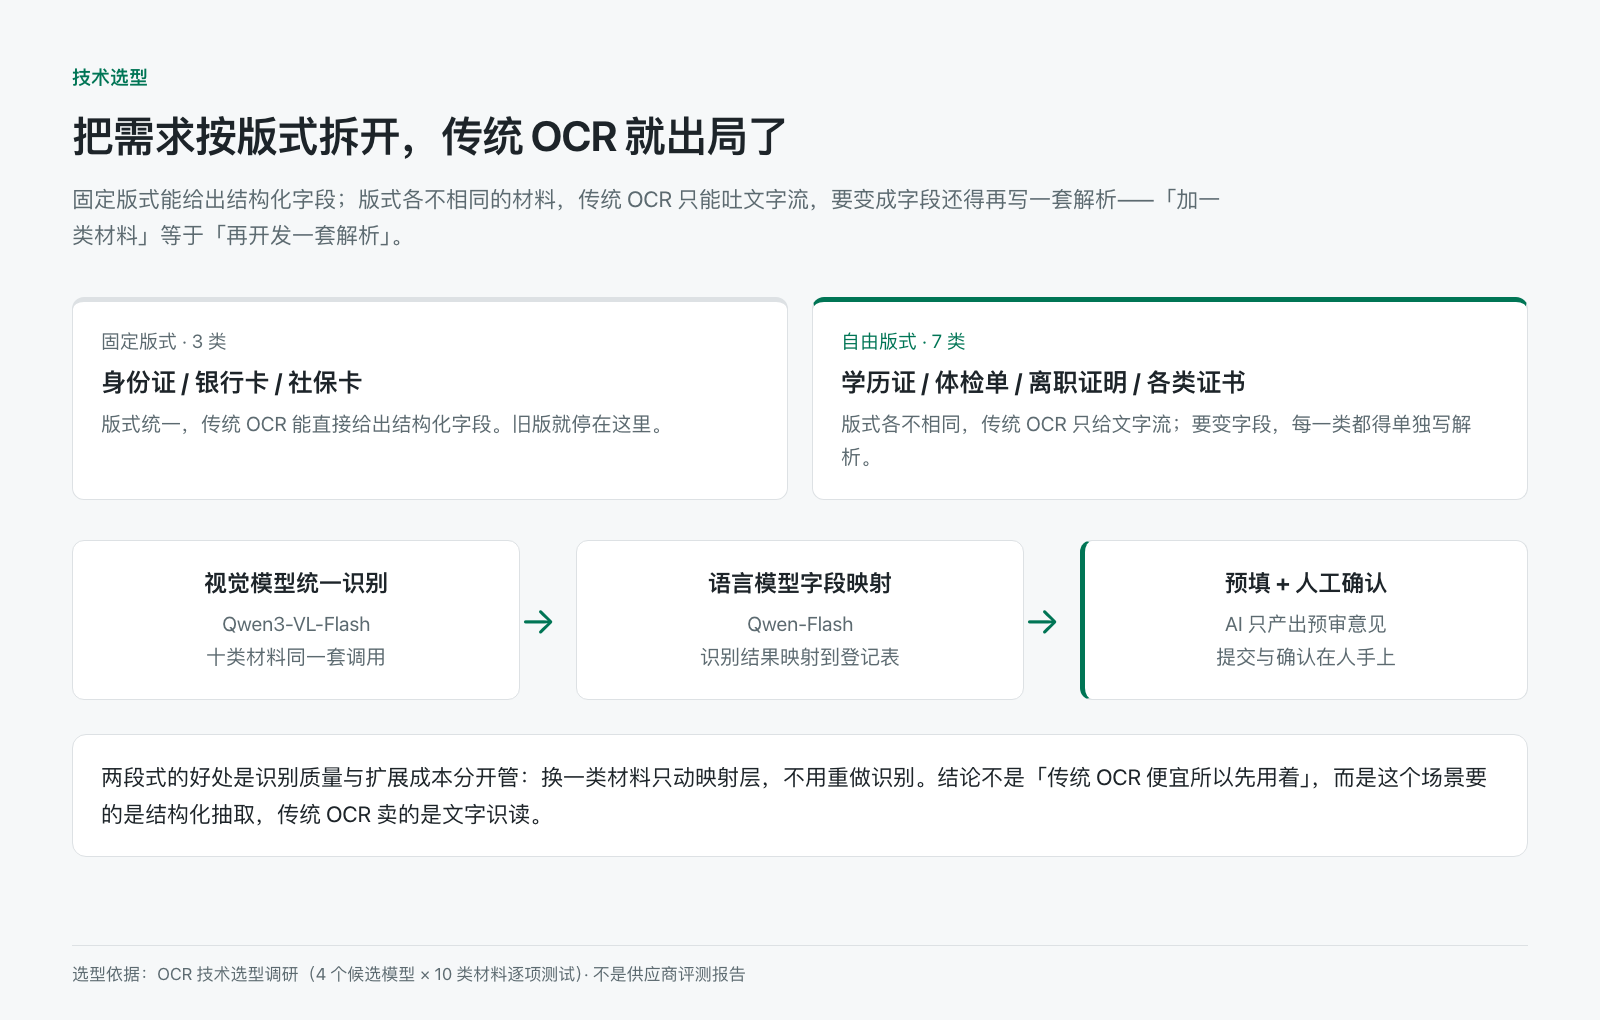
- 固定版式只有三类——身份证、银行卡、社保卡,传统 OCR 能给出结构化字段
- 其余七类版式各不相同,传统 OCR 只能吐文字流,要变成字段还得再写一套解析
传统 OCR 在版式覆盖和成本上都不过关,最终选用 Qwen3-VL-Flash 做统一识别,再接 Qwen-Flash 把识别结果映射到登记表字段。
两段式的好处是识别质量与扩展成本分开管,换一类材料只动映射层。这个场景要的是结构化抽取,传统 OCR 卖的是文字识读——买错比买贵更贵。
3. 上线后把 7,272 条差异逐条挖开
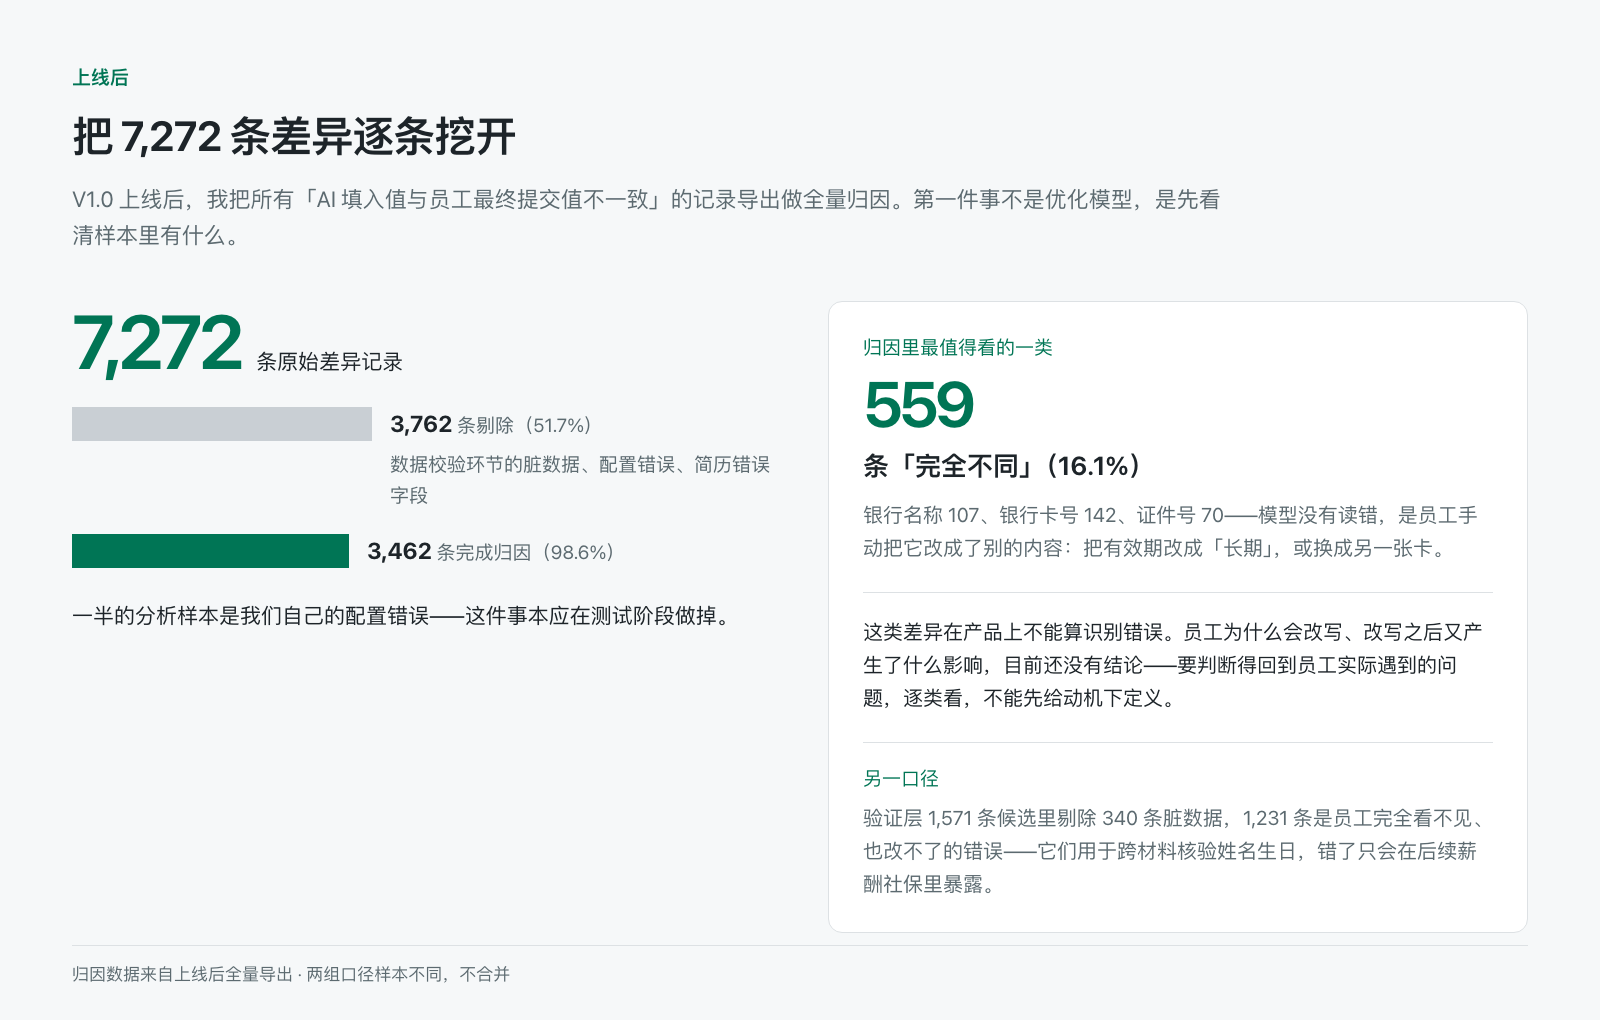
V1.0 上线后,我把所有「AI 填入值与员工最终提交值不一致」的记录导出,做全量归因。先看清样本里有什么,再谈优化模型:
- 原始差异记录 7,272 条
- 剔除数据校验环节的脏数据、配置错误、简历错误字段共 3,762 条(51.7%)
- 有效记录 3,510 条,完成归因 3,462 条(98.6%)
一半的分析样本是我们自己的配置错误——这件事本应在测试阶段做掉,我放到上线后才发现。
归因里最值得看的一类是「完全不同」:559 条(16.1%),银行名称 107、银行卡号 142、证件号 70。模型没有读错,是员工手动把它改成了别的内容——把有效期改成「长期」,或者换成另一张卡。
这类差异在产品上不能算识别错误,但员工为什么会改写、改写之后又产生了什么影响,目前还没有结论。要判断得回到员工实际遇到的问题,逐类看,不能先给动机下定义。
另一轮按校验环节口径统计:1,571 条候选中剔除 340 条脏数据,剩下 1,231 条来自员工看不见、也改不了的字段——这些字段用于跨材料核验姓名和生日,错了只会在后续薪酬社保环节暴露。两组样本不同,分开列出。
4. 三个动作
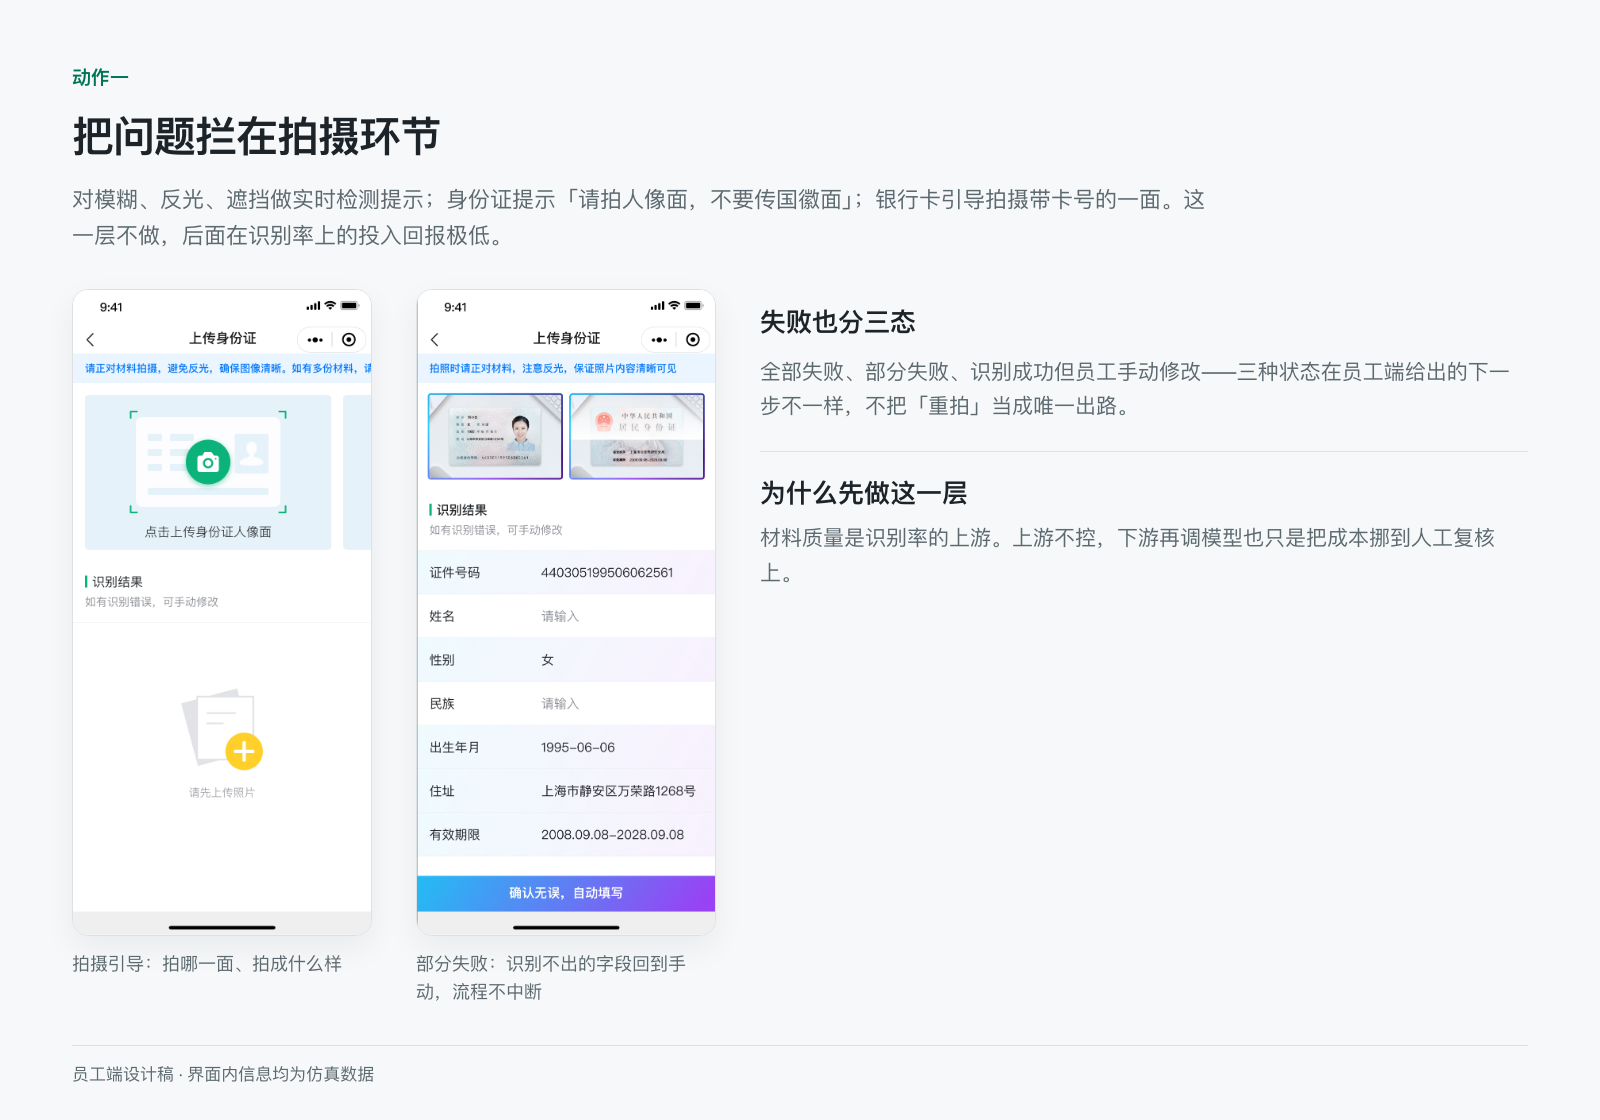
一、把问题拦在拍摄环节。 对模糊、反光、遮挡做实时检测提示;身份证提示「请拍人像面,不要传国徽面」;银行卡引导拍摄带卡号的一面。这一层不做,后面在识别率上的投入回报极低。失败也分三态——全部失败、部分失败、识别成功但员工手动修改——三种状态给出的下一步不一样,不把「重拍」当成唯一出路。
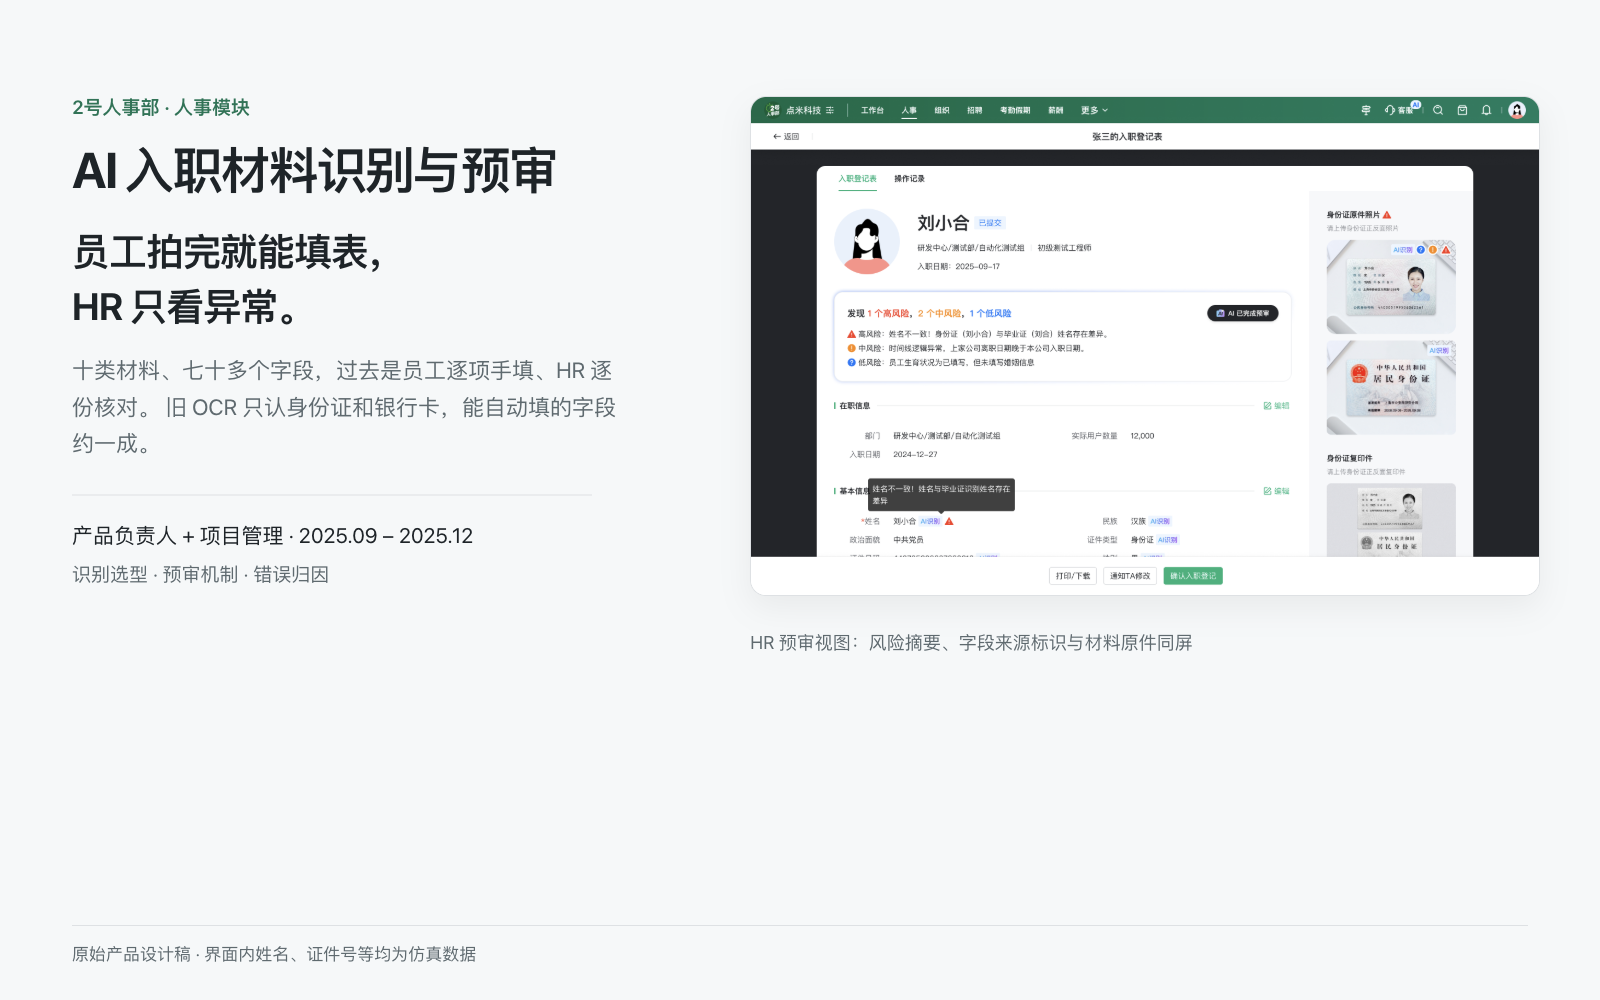
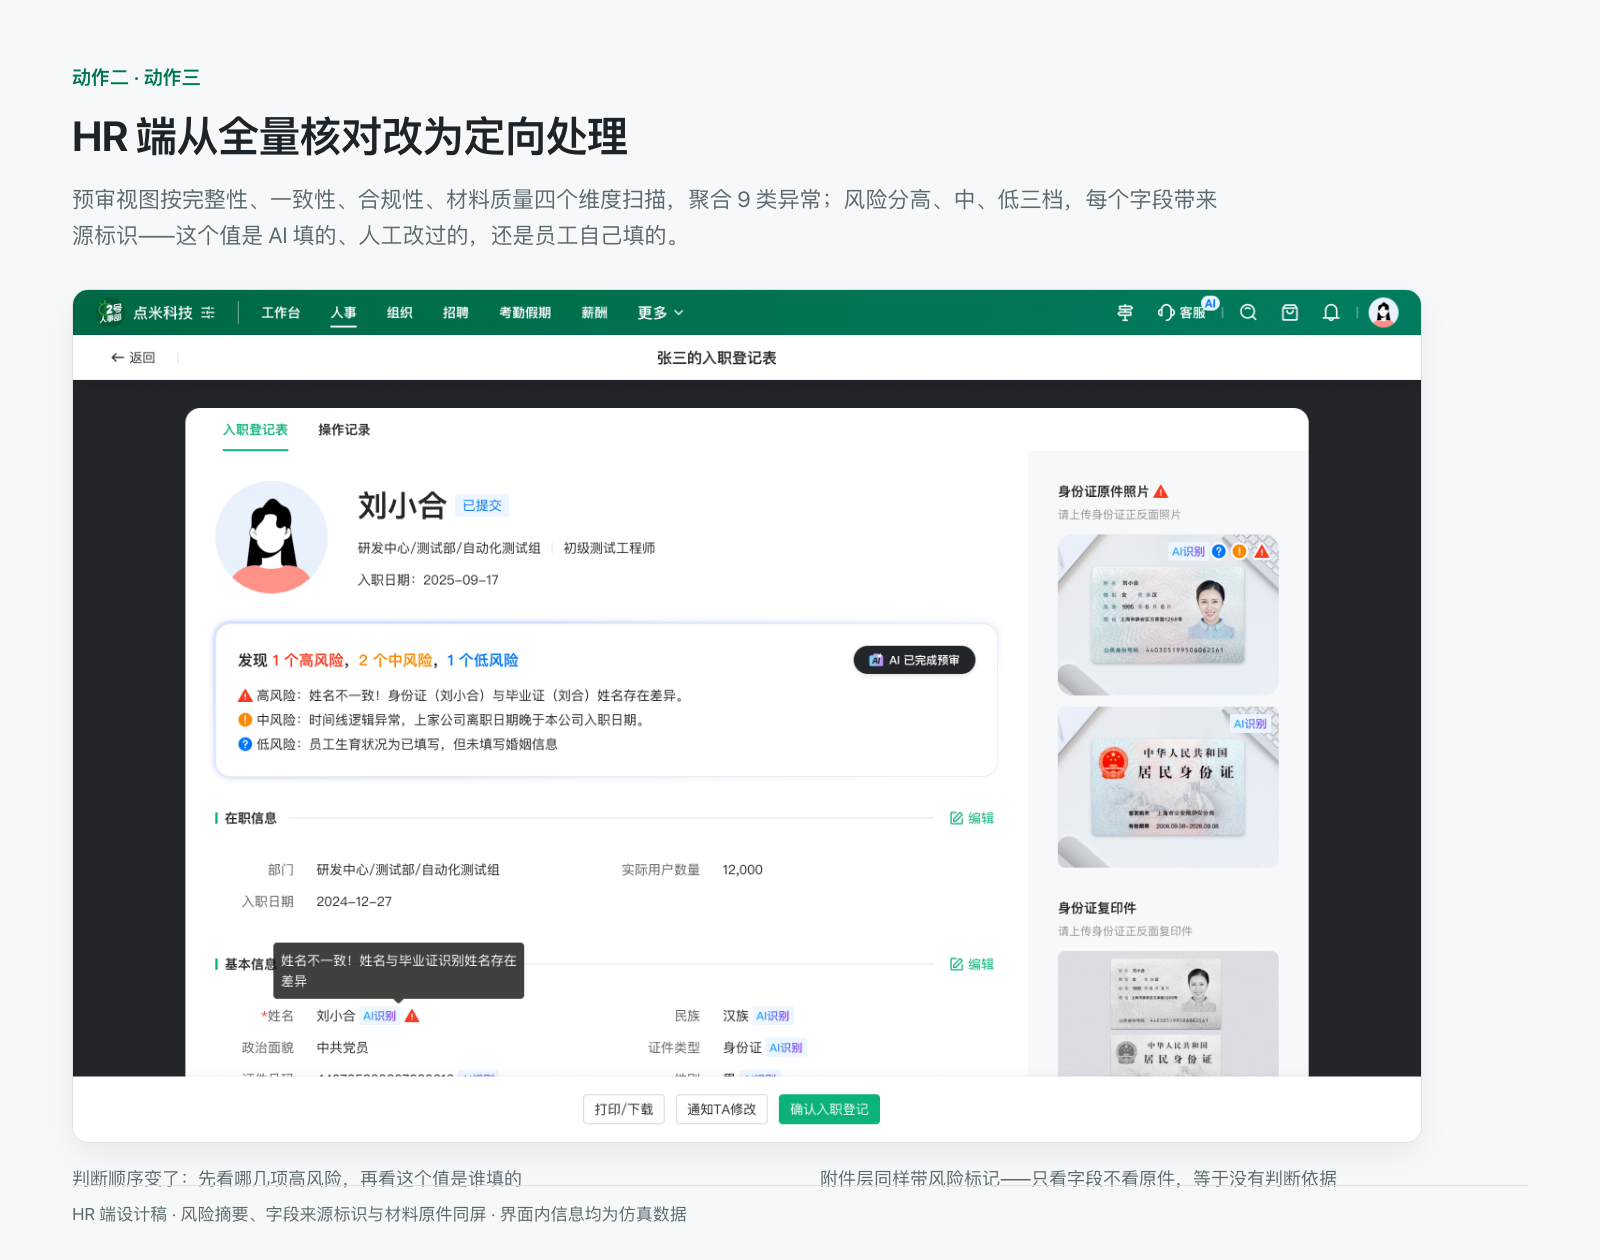
二、HR 端从全量核对改为定向处理。 预审视图按完整性、一致性、合规性、材料质量四个维度扫描,聚合 9 类异常,风险分高、中、低三档。每个字段标注来源:AI 填的、人工改过的,还是员工自己填的。HR 的判断顺序因此变成「先看哪几项高风险,再看这个值是谁填的」。
三、附件层同样要有风险标记。 只看字段不看原件,等于没有判断依据。预审汇总、字段来源与附件材料同屏。
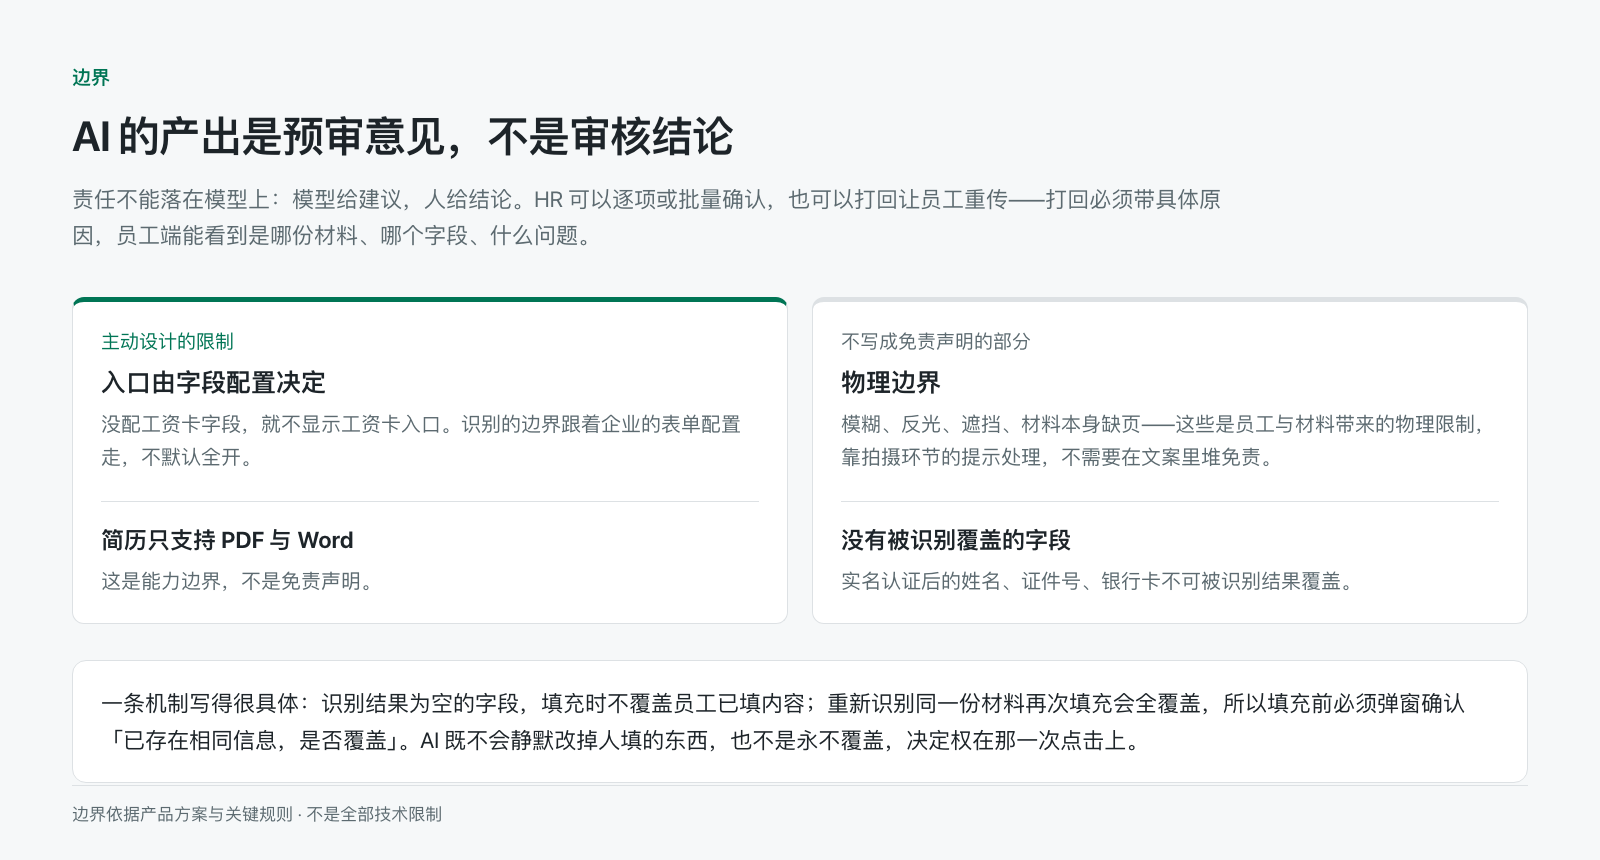
填充有一条硬规则:识别结果为空的字段,不会改写员工已填的内容;对同一份材料再次点击填充会覆盖已填内容,所以覆盖前必须弹窗确认「入职登记表已存在相同信息,是否覆盖」。要不要覆盖,由填充前的那次点击确认决定。
5. 结果与边界
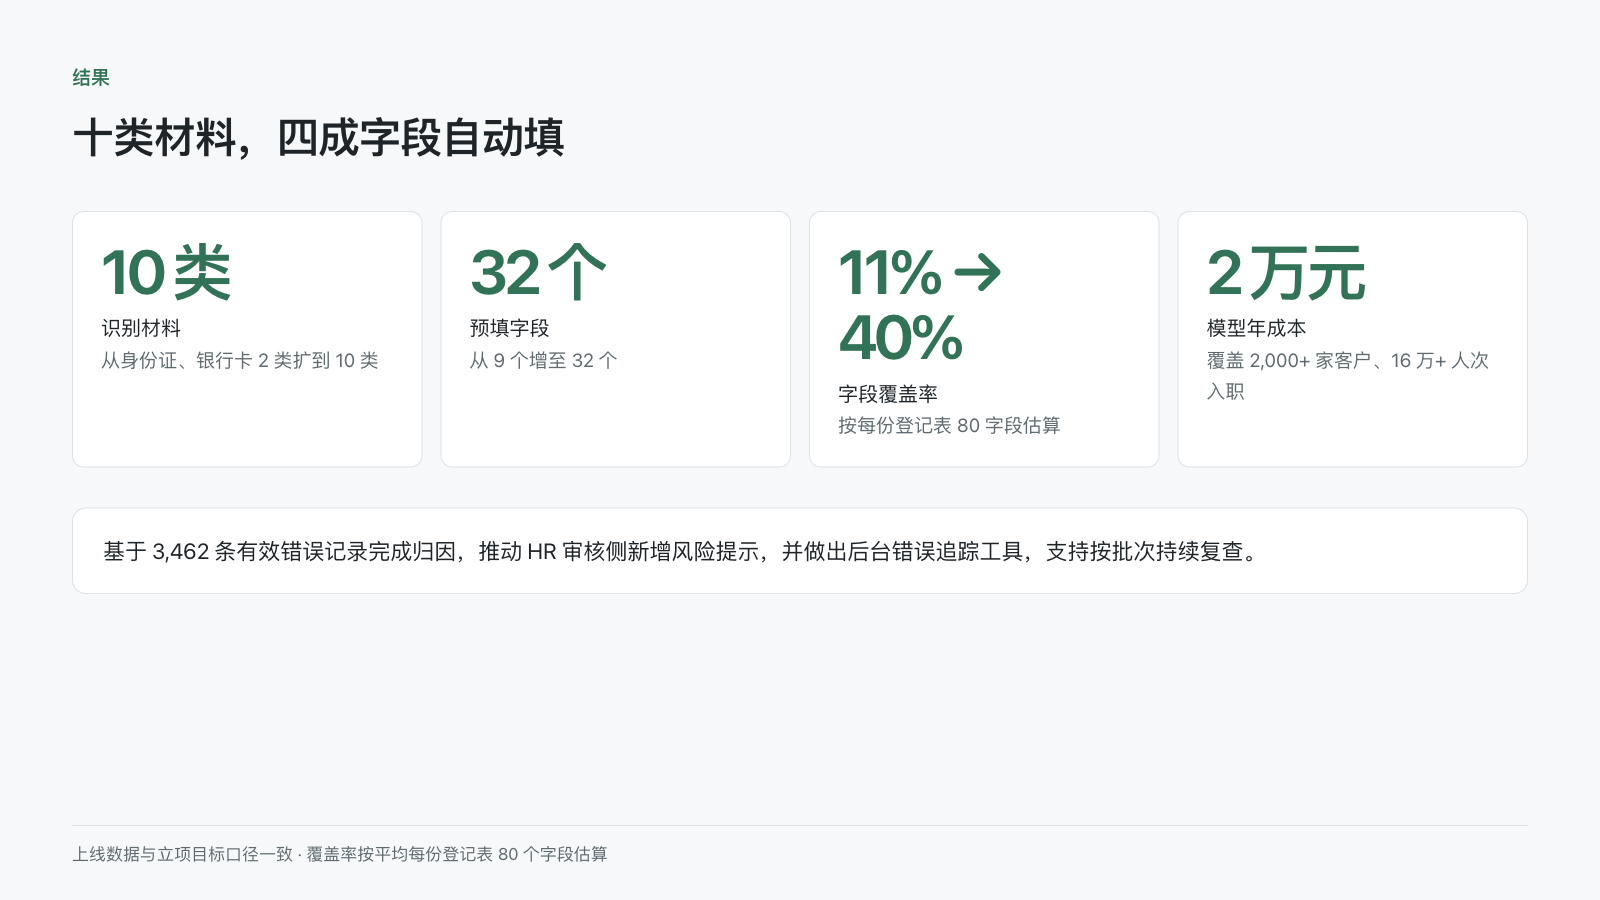
识别材料从 2 类扩展到 10 类;自动填充字段从 9 个增至 32 个,字段覆盖率 11% → 40%;模型成本 2 万元/年。这套能力覆盖 2,000+ 家客户企业、16 万+ 人次入职场景。
基于 3,462 条有效错误记录完成归因,推动 HR 审核侧新增风险提示,并做出后台错误追踪工具,支持按批次持续复查。
边界只保留两条有意为之的设计:识别入口由登记表字段配置决定,没配工资卡字段就不显示工资卡入口;简历只支持 PDF 与 Word。实名认证后的姓名、证件号、银行卡不可被识别结果覆盖。其余限制来自员工与材料本身。
6. 可迁移的判断
- 「识别准确率」是会骗人的指标。 它只统计模型输出了什么,不统计人为什么改、材料为什么错。
- 做 AI 产品先把错误来源拆开,再谈优化。 配置错误占样本一半时,盯着模型指标等于把力气打在空气上。
- 责任不能落在模型上。 模型给建议,人给结论。
- 改写动作要单独看,但别急着解释它。 它标记的是人与 AI 的分歧点;分歧的原因得另找证据,不能直接当成信任度或准确率指标。